一个模型“能算”,究竟证明了什么?
给你四位二进制数 1, 0, 1, 1,问其中有奇数个还是偶数个 1。答案是奇数。下面把这道题当作教学例子:我们先亲手算,再看关于 Transformer 的理论究竟承诺了哪一部分。
一个算法从左到右维护一位状态。初值是 0,遇到 1 就翻转,遇到 0 就保持:
| 读入 | 新状态 |
|---|---|
| 1 | 1 |
| 0 | 1 |
| 1 | 0 |
| 1 | 1 |
最后的 1 表示奇数。另一个算法可以先并行算两对:1 XOR 0 = 1、1 XOR 1 = 0,再算 1 XOR 0 = 1。前者逐位推进;后者用树形组合换取较少的串行层级。这里描述的是两个手写算法,还没有训练任何网络。
这个区别已经足以改变我们读定理的方式。问题相同,允许的计算组织不同,“需要多少步”就可能不同。
先把“能”拆成三个问题
假设我们只关心长度为四的输入。总共有 16 种,甚至可以做一张完整查找表。证明一个模型装得下这张表,只回答了:模型类里面有没有一个正确解?
接着随机初始化参数,用一部分样本训练。优化器能否找到正确解,是第二个问题。查找表确实存在,对训练过程的帮助仍可能有限。
最后把输入改成八位。原来的四位表不再够用;维护奇偶状态的更新规则却可以继续执行。训练得到的是表、规则,还是另一种表示,需要额外证据。即使四位上的 16 种输入都答对,也不能区分它们。
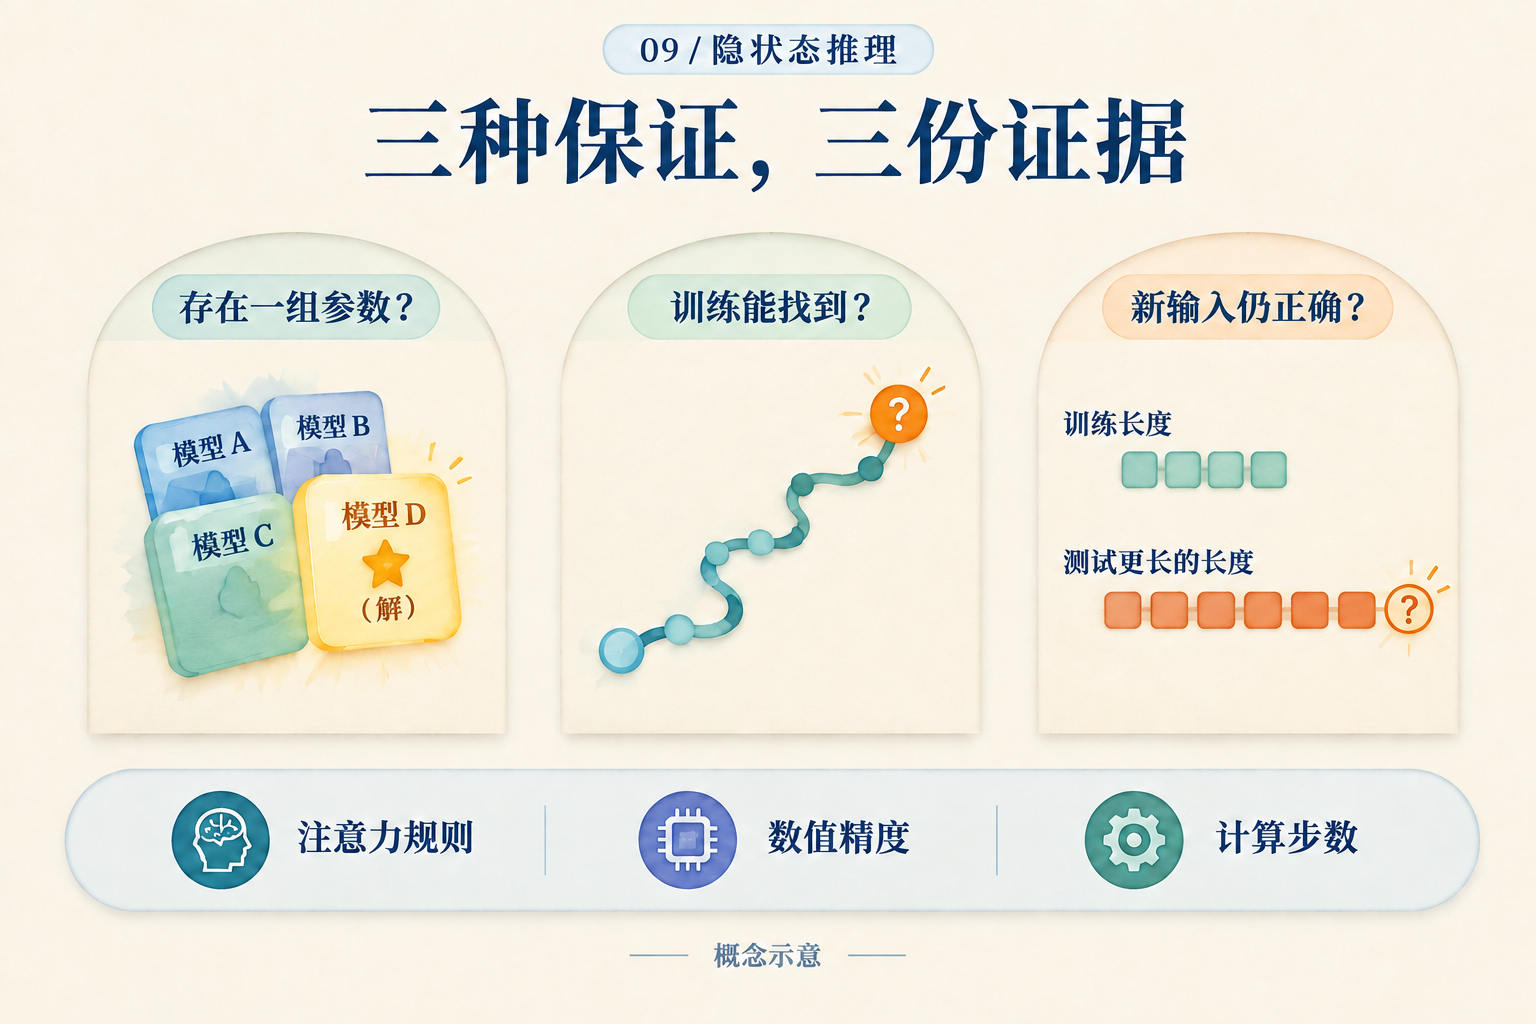
左边问模型类包含什么,中间问训练走到哪里,右边问测试条件改变后会怎样。图中的轨迹是概念示意。
“对每个长度,都能找到一组适合它的参数”和“同一组参数适用于所有长度”也不同。前一句允许每增加一个长度就重新设计模型;后一句要求同一个系统继续工作。读定理时,注意“对所有”与“存在”的先后顺序,比先记住结论的名称更有用。
为什么注意力规则会改变答案?
Merrill 与 Sabharwal 研究带中间解码的 Transformer。他们的构造让线性数量的中间步骤足以识别任意正则语言;奇偶校验就是正则语言中的一个例子。这里的“足以”是存在性构造,参数按目标算法设计,不是普通预训练一定能学会的保证。原论文 v5,定理1
构造使用对数增长的数值精度、饱和注意力和 projected pre-norm。饱和注意力会把权重平均分给并列最高分的位置;projected pre-norm 则允许对投影后的表示归一化。更强的图灵机模拟还要求严格因果掩码。这些条件定义了定理里的计算机器。论文关于相对无中间步骤模型的严格能力分离,还依赖相应复杂度类不坍缩的假设。同文,§2.1、定理1–2
换一种机器,结论就要重读。UHAT 的每个注意力头只选一个位置,分数并列时按固定规则选定。Bavandpour 等证明:在层数和头数一致有界的这个模型族中,奇偶校验需要 Ω(n) 长度的 CoT;宽度不必固定,模型也允许随长度变化。ICML 2025,定义2.2、定理4.2
Ω(n) 是随长度增长的下界:足够长时,所需链长至少是输入长度的某个正比例。它没有给出“四位恰好需要四个词元”的结论,也不能直接套到所有 softmax 模型。
为何不直接说“一个头只看一位,所以必须看 n 次”?因为选中哪个位置也依赖输入,选择本身可能传递信息。原证明需要处理这条间接通道。教学算法可以帮助想象计算,不能替代下界证明。
“任意逼近”允许哪些东西变化?
循环模型反复用同一个模块,看起来不如每层都有独立参数灵活。Xu 与 Sato 研究它能逼近哪些函数:输入长度固定,目标是紧致区域上的连续、置换等变映射,误差按 Lᵖ 范数衡量,循环次数大于序列长度。ICML 2025,定理3.6
“置换等变”可以这样理解:把一组位置重新排列,输出也按同样方式排列。这个条件规定了一类函数,而不是所有可能的输入输出关系。“固定长度”则意味着证明首先在同一个输入空间里展开,没有自动跨到更长的序列。
通用逼近推论允许无限精度权重;理论架构还排除了层归一化。它提供的是模型类的能力边界,不是把某个训练好的 BF16 模型多跑几轮就会改善的承诺。时间步编码是论文提出的增强设计,深度外推仍需另外测试。同文,§2.1、推论3.7、§4
哪种结果真的讨论“怎样学”?
Log-ICoT 把问题推进到训练。它针对树形 k-parity,按树的层级撤去中间监督,使用 log₂(k) 个训练阶段。以四个参与计算的位为例,树有两层组合:先组合叶子对,再组合结果;这个小例子解释课程的层级,不能代替定理的样本量要求。原论文 v1,§3.1–3.3
保证对应特定模型与优化程序:注意力的可训练部分依赖位置编码,值映射固定,还有专门的连接函数、门控、树层级掩码、分块移位和量化更新。批量、初始化、学习率及梯度精度受约束。正因为这些设计被写清楚,作者才能分析训练怎样逐层吸收计算。
测试时,中间 CoT 位置并未删除,而是填零后保留。一次前向省去了逐个生成中间词元,仍然要计算这些位置。同文,§3.1 Evaluation
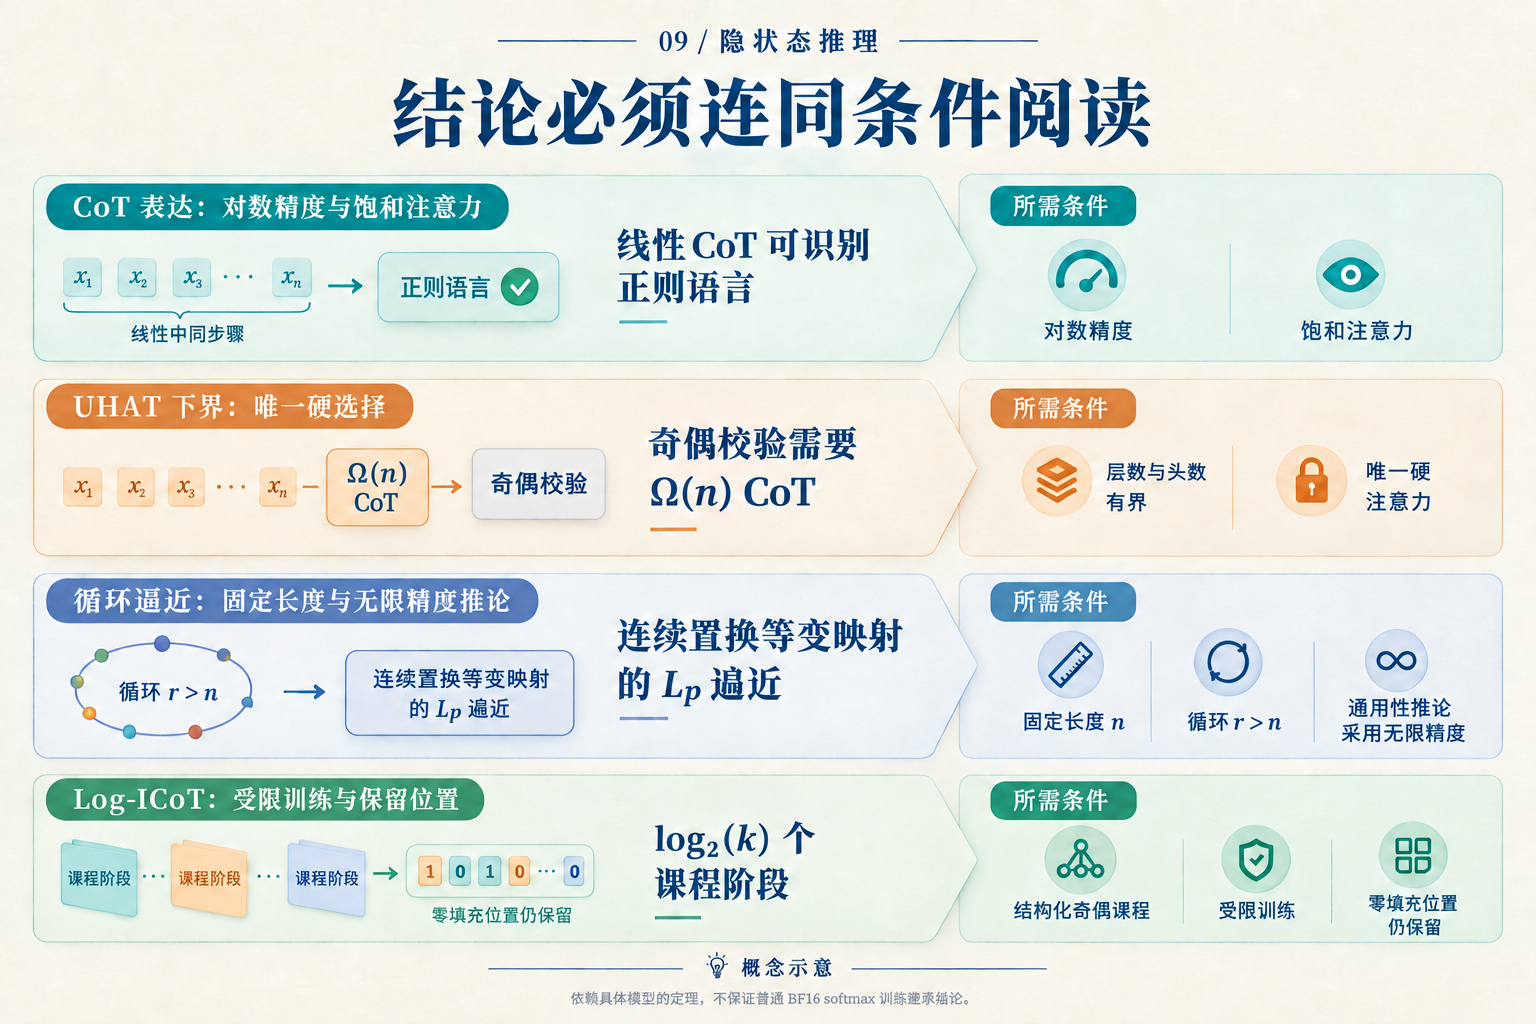
把这张图当作读完正文后的索引。每行省略了部分技术条件,使用结论时仍需回到对应定理。
回到 1, 0, 1, 1。我们已经会算它,但关于一个神经模型,还有三份不同的工作:证明其模型类包含解,解释训练如何找到解,检验同一组参数能否在新长度上继续工作。读到“模型能推理”时,先把这句话改写成其中一个具体问题,再核对它允许使用的时间、空间、精度与训练信息。