判断合成数据会不会让模型退化,先要问:下一代还能看到哪些旧数据?只学最新一批生成样本,和在不断扩大的档案上训练,是两种不同的反馈过程。“模型学习自己的输出”没有说明运行的是哪一种。
这也解释了为什么坍塌结果与累积结果可以同时成立。它们考察不同的跨代信息传递方式。使用任何一项结论,都得保留数据配方、评价指标和计算预算。
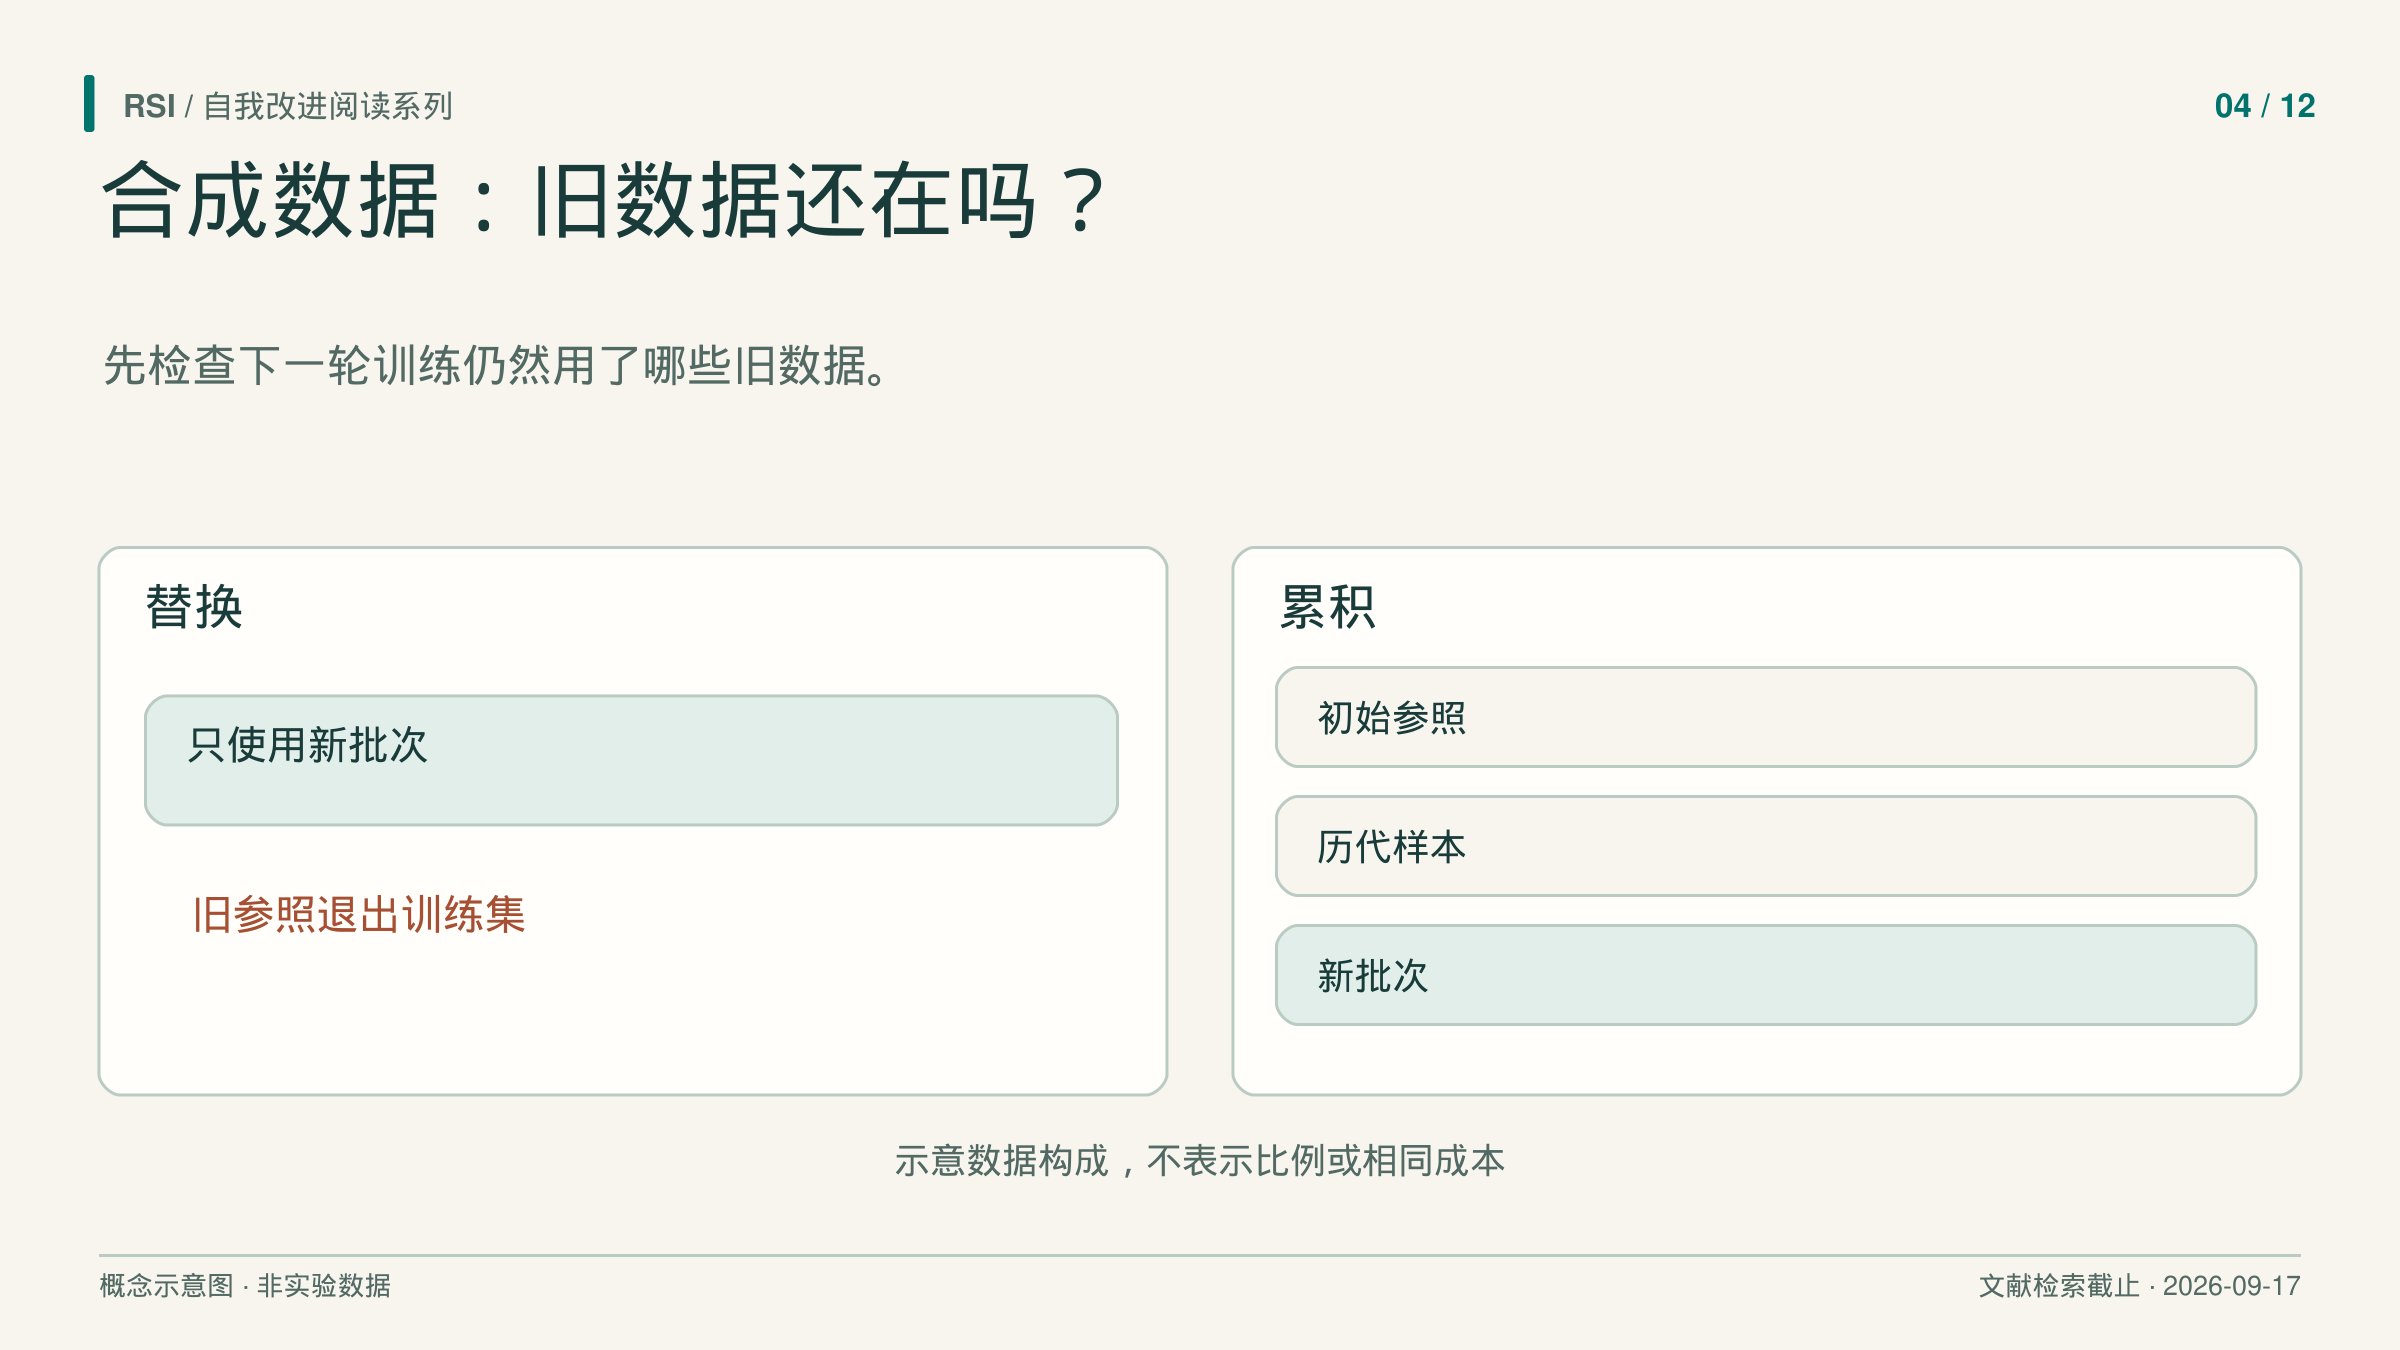
先检查下一轮训练集中还剩什么。
一个小档案的思想实验
设想档案里有许多常见例子,也有少量特殊例子。模型学习后生成新样本,一些特殊例子可能没有出现在有限的新样本中。如果丢弃旧档案,下一代就无法通过训练集直接访问这些被遗漏的例子。
如果保留档案,并把新样本加入其中,那些例子仍然可见。这不保证训练程序能有效使用它们,但改变了程序能够访问的信息。
这是教学例子,不是实测轨迹,也没有声称每一代必然损失固定比例的罕见事件。它指出了一项可以检查的决定:新合成数据是替换旧数据,还是加入旧数据?
一项坍塌实验说明了什么?
Shumailov 等人研究递归使用生成数据时,原始分布的信息怎样丢失。这里讨论的语言模型实验,每代都从预训练 OPT-125M 重新微调,而非继续训练上一代权重。
生成时,模型以原始文本的 64 个 token 为前缀,用五路束搜索产生后续 64 个 token,再用等规模生成数据训练后代。作者在原始 WikiText2 测试集上评价,进行了五次独立运行。
后代表现低于最初在原始数据上微调的模型,但图中第一至第九代并不逐代单调恶化。后代可能比紧邻的上一代好,同时仍比初始参照差。“每代都变差”会把观察到的退化改写成轨迹并不支持的更强结论。
论文还考察保留 10% 原始数据的设置,退化较小。不过,该设置训练十个 epoch,而不保留时训练五个。一个 epoch 是完整遍历训练集一次。保留方式与训练量同时改变,因此不能把差异完全归因于保留比例,也不能说整篇论文只研究纯替换。论文
将坍塌结果联系到其他自训练方法时,这些区别很重要。用已知答案筛选生成推理,增加了一种选择信号;执行程序检查结果,又是另一种。递归文本生成实验不能自动代表这两类过程。
保留档案,实验也就变了
Gerstgrasser 等人明确比较替换与累积。累积配方在新样本到来时,保留初始参照和历代合成样本。跨代留下的是数据,每代模型仍重新初始化。
在 TinyStories 上,小型 GPT-2 与 Llama2 模型的五代实验中,替换使测试交叉熵升高,累积则持平或下降。交叉熵衡量模型预测测试文本的效果,在该指标上越低越好。这些是有限代际的小模型实验,不是无限代际保证。
TinyStories 的初始参照本身由 GPT-3.5 和 GPT-4 生成。这里“真实数据”是相对于后代的初始参照,不能改写为“人工写作数据”,否则会弄错被保留信息的来源。
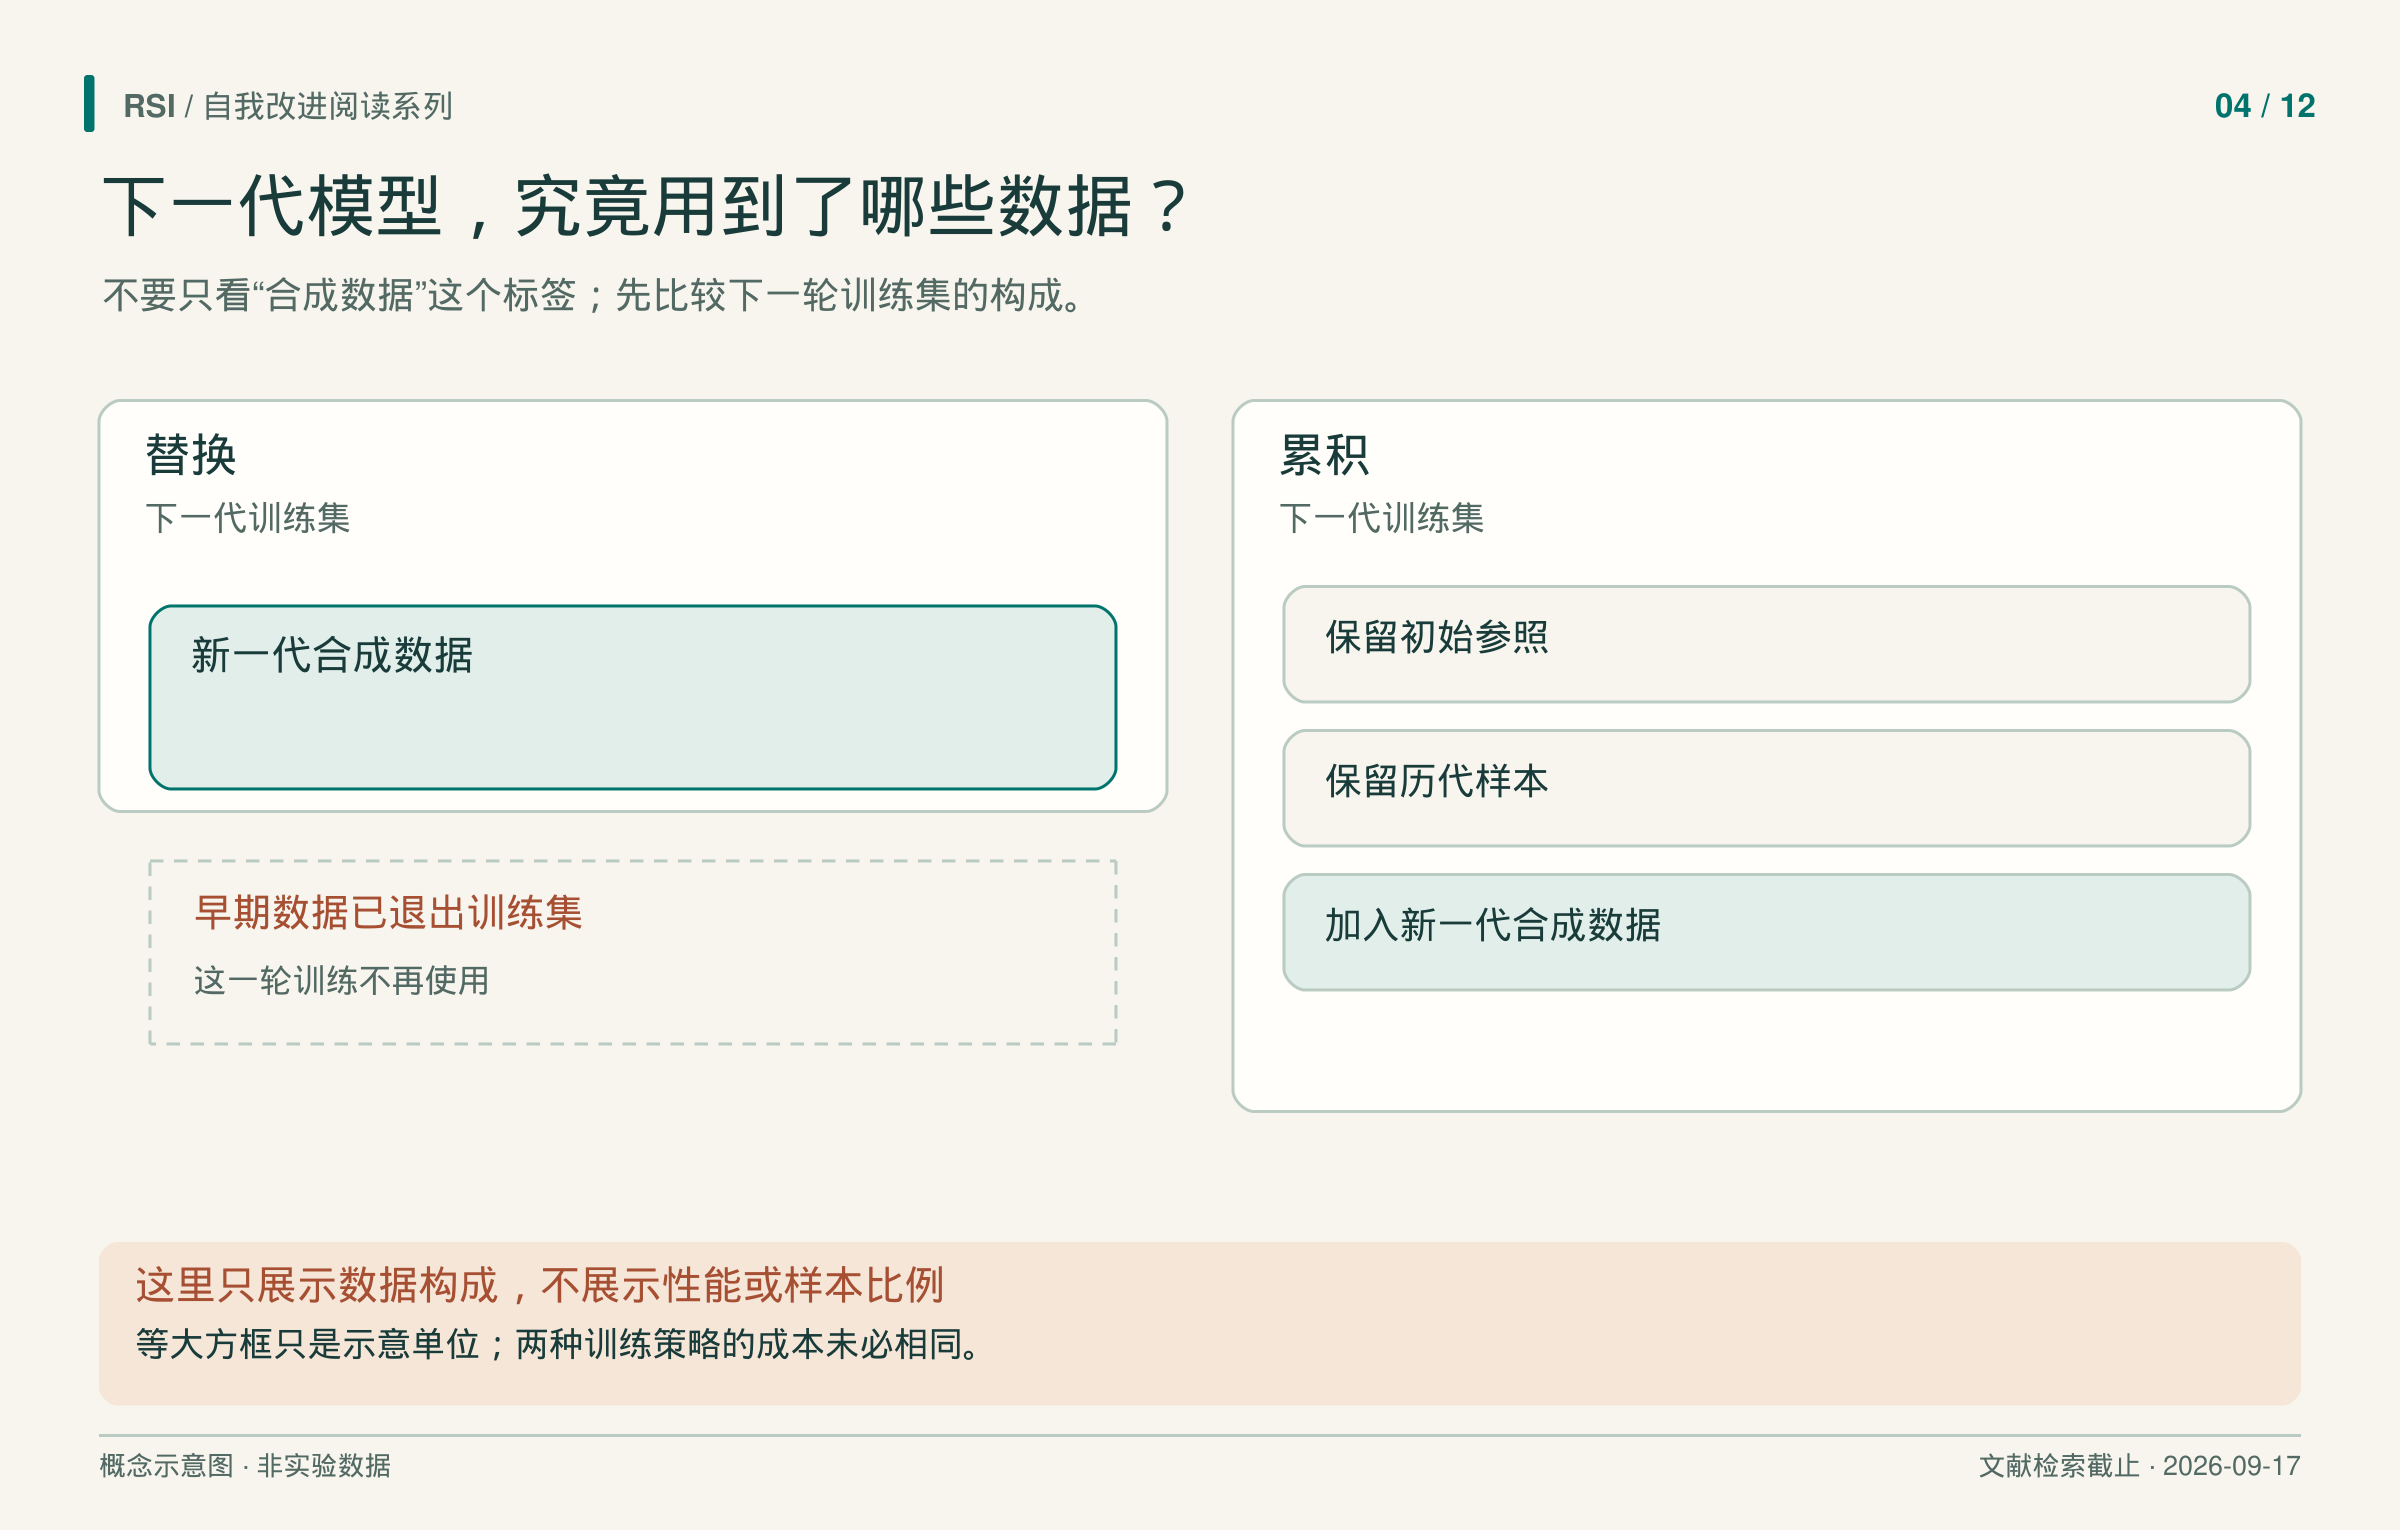
图示只表达数据构成,不表示样本比例、实测表现或相同计算成本。
累积也增加训练成本。每代都训练一个 epoch 时,档案越大,梯度更新步数就越多。论文另有扩大纯合成数据量的对照,但累积本身不能被描述成等算力下的免费收益。比较单位需要明确。
有限误差定理为什么要带着条件读?
累积论文还提供了一个可以直接计算误差的线性回归例子。它解释某种机制怎样控制误差传播,适用对象是这套具体模型。
输入维度为 d,每轮新增 T 个样本。初始输入矩阵 X 的 T 行独立同分布地采自 N(0, I_d),即零均值、单位协方差的高斯分布,后续每代复用完全相同的 X。初始标签是真实线性关系加高斯噪声;后续标签则是前代模型预测加新高斯噪声。各轮标签噪声均值为零、方差为 sigma²。
噪声在不同样本、不同轮次之间均独立,并且独立于 X。原始数据永久保留,每次用无正则最小二乘拟合。这里没有每轮获得新的真实标签。
评价使用独立采自初始真实线性分布的测试样本,并对训练数据与噪声取期望。在这些条件下,要求 T ≥ d + 2,先定义:
C = sigma² × d / (T − d − 1)
经过 n 轮的期望超额测试均方误差为:
E_excess(n) = C × (1 + 1/2² + … + 1/n²) ≤ C × π²/6
“超额”表示已经扣除不可约噪声方差,所以它不是总测试误差。第一轮是初始拟合,第 n 轮包含 n − 1 次后继合成。平方倒数项具有有限总和,由此得到上界。定理及设定
公式里的条件都有作用。复用 X、保留初始观测、独立高斯噪声和拟合规则,都是结论的一部分。更改输入分布、样本权重或学习程序,需要另作论证。不能仅因训练文件夹不断变大,就把这个界套到神经网络上。
误差稳定与细节保留,是两个目标
同一论文在变分自编码器实验中,也承认累积时误差仍可能缓慢增加,并丢失细节。其“不坍塌”讨论关注的是误差是否按所选定义持续、无界恶化,与永久保留原分布的每项性质不同。
实际评测应同时写清数据策略和目标。记录每代能看见哪些初始与生成批次;记录保留比例与采样方式;除了 epoch 数,也比较计算投入;使用保留的参照评价,并检查真正需要保留的例子类型,避免仅依赖一个平均值。
例如,档案中的某类罕见技术案例若对应用很重要,就应专门检查这类案例。平均预测分数回答的是平均问题,不能单独说明罕见案例是否仍可学习、后续任务能否使用它们。先写清需要保留的能力,再选择指标,才能让评测区分真正影响使用的结果。“旧数据还在”是一项输入条件,不能跳过对输出的检查。
这些是由论文比较引出的实验建议,不是任何配方必然有效的保证。仅凭数据来自模型,无法判断循环会纠正错误、重复错误,还是丢失信息。首先值得问的是:下一代被允许忘掉什么?
参考来源
- Shumailov 等,《The Curse of Recursion: Training on Generated Data Makes Models Forget》,v3,2024。
- Gerstgrasser 等,《Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data》,v2,2024。
本文基于文献纳入截至 2026 年 9 月 17 日的书稿整理。 所述实验结果来自论文报告,本系列未复现实验。